Adapter l’interface utilisateur aux modèles locaux : optimisation, sécurité et conformité européenne
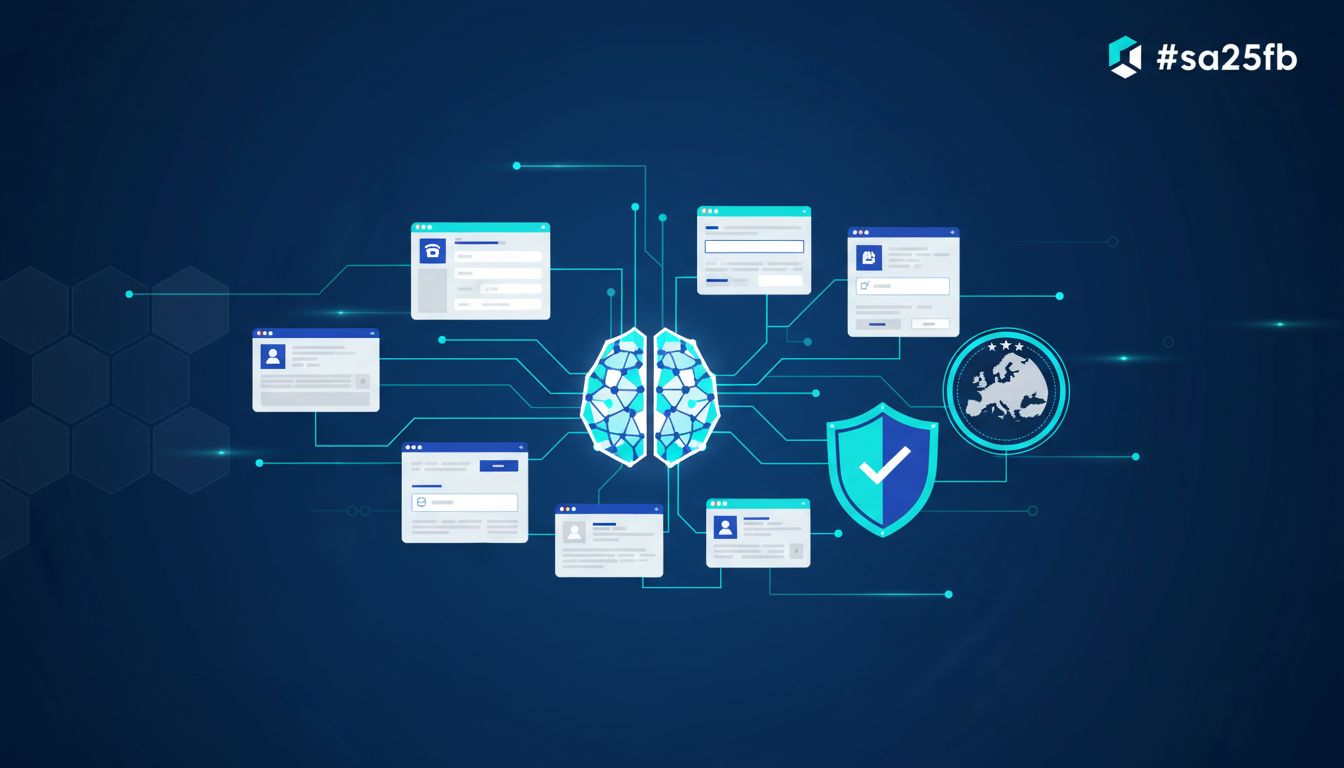
Adapter une interface utilisateur à des modèles locaux ne consiste pas uniquement à remplacer une API cloud par un moteur exécuté sur un poste ou dans une infrastructure interne. Cette évolution transforme l’expérience produit, les flux de données, les mécanismes de sécurité et les responsabilités de conformité. Pour les entreprises européennes, l’interface devient un point de contrôle essentiel entre l’utilisateur, le modèle et les données traitées.
Les modèles locaux peuvent réduire les transferts vers des services tiers, améliorer la latence et offrir davantage de contrôle opérationnel. Ils ne dispensent toutefois ni du RGPD ni de l’AI Act. Dès qu’un système interagit avec des personnes situées dans l’Union européenne, la transparence, la minimisation des données, la traçabilité et la sécurité doivent être intégrées dès la conception de l’UI.
Repenser l’interface autour des contraintes des modèles locaux
Un modèle local dispose souvent de ressources limitées par rapport à une infrastructure cloud : mémoire disponible, puissance de calcul, taille du contexte ou capacité de traitement simultané. L’interface doit donc guider l’utilisateur vers des requêtes efficaces. Des limites de longueur explicites, une estimation du temps de réponse et une gestion claire des files d’attente évitent les expériences imprévisibles.
La conception peut également privilégier des interactions structurées plutôt qu’un champ de texte entièrement ouvert. Des actions prédéfinies, des formulaires guidés et des suggestions contextuelles réduisent la complexité des invites et améliorent la qualité des résultats. Cette approche est particulièrement utile lorsque le modèle local fonctionne sur un appareil mobile, un poste industriel ou un environnement déconnecté.
La dégradation progressive doit être prévue dès le départ. Si la mémoire est insuffisante, si le modèle n’est pas disponible ou si une fonctionnalité nécessite une capacité absente du système, l’interface doit proposer une alternative compréhensible. Un message technique comme « erreur d’inférence » ne suffit pas : l’utilisateur doit connaître la conséquence, la cause probable et l’action possible.
Rendre la présence de l’IA visible et compréhensible
Depuis le 2 août 2026, les obligations de transparence de l’article 50 de l’AI Act s’appliquent aux systèmes concernés. Les lignes directrices de la Commission insistent sur un signalement clair lorsque l’utilisateur interagit avec une IA. Cette exigence concerne directement les écrans d’accueil, les microcopies, les infobulles, les avatars et les composants de conversation.
Le signalement ne doit pas être dissimulé dans les conditions générales ou dans une page juridique secondaire. Une mention visible comme « Vous échangez avec un assistant IA exécuté localement » peut être complétée par une infobulle expliquant le fonctionnement, les limites du système et la gestion des données. Le niveau de détail doit rester proportionné au contexte et au risque associé à l’usage.
La transparence doit rester cohérente dans l’ensemble du parcours. Lorsqu’un utilisateur passe d’une réponse générée à une action automatisée, l’interface doit distinguer clairement la suggestion, la décision et l’exécution. Dans les secteurs sensibles, une confirmation humaine, un mécanisme de recours et un accès à une information vérifiable doivent compléter le simple étiquetage de l’IA.
Minimiser les données collectées par l’interface
L’exécution locale réduit souvent les transferts vers le cloud, mais elle ne rend pas les données automatiquement conformes. Les invites, historiques, journaux, captures d’écran, fichiers temporaires et métadonnées peuvent rester stockés sur le poste ou être synchronisés avec d’autres systèmes. Le principe de privacy by design and by default, rappelé par le considérant 69 de l’AI Act, doit guider chaque flux.
Concrètement, l’interface doit demander uniquement les informations nécessaires à la tâche. Un assistant de rédaction n’a pas nécessairement besoin de conserver l’intégralité d’une session, tandis qu’un outil d’analyse documentaire peut fonctionner avec un traitement temporaire et une suppression automatique. Des options de conservation distinctes, compréhensibles et désactivées par défaut lorsque cela est pertinent renforcent la maîtrise des utilisateurs.
Les équipes doivent également examiner les données qui alimentent l’amélioration du modèle. Le scraping de données publiques pour entraîner ou enrichir un système génératif reste encadré par le RGPD. En 2026, l’EDPB a rappelé qu’une base légale est nécessaire et que le traitement de données sensibles exige à la fois une base de l’article 6 et une exception applicable de l’article 9(2).
Sécuriser les interactions et prévenir les fuites
Une interface locale peut exposer des informations personnelles par extraction de données d’entraînement, régurgitation, inversion de modèle ou attaque de type membership inference. Ces risques concernent notamment les assistants qui conservent des documents, des conversations ou des préférences sur le poste de l’utilisateur. Les tests doivent donc porter sur les sorties visibles, mais aussi sur les fonctions de recherche, d’export et d’historique.
L’EDPB recommande des évaluations robustes, documentées et proportionnées aux moyens raisonnablement susceptibles d’être utilisés par un attaquant. Il faut tester les invites adversariales, les tentatives d’extraction, les contournements de garde-fous et les scénarios dans lesquels un utilisateur accède à des données appartenant à un autre profil. Chaque test doit produire des preuves exploitables pour l’audit et la remédiation.
La sécurité de l’UI doit aussi empêcher l’escalade de privilèges. Une réponse générée ne devrait pas pouvoir déclencher seule une opération sensible, modifier une configuration ou transmettre un document confidentiel. La séparation des rôles, la confirmation explicite, le contrôle des permissions et la journalisation sélective constituent des garde-fous essentiels, notamment dans la santé, l’énergie, l’industrie et l’automobile.
Marquer les sorties et garantir l’interopérabilité
L’article 50 impose également que les sorties générées par des systèmes d’IA générative soient marquées au moyen d’identifiants lisibles par machine, efficaces, fiables, robustes et interopérables. Cette obligation dépasse l’affichage d’un simple badge dans l’interface. Elle concerne les exports, les téléchargements, les API et les contenus transmis à d’autres applications.
Un produit doit donc définir une stratégie de provenance dès la conception. Les métadonnées peuvent indiquer qu’un contenu a été généré, le modèle utilisé, la date de production ou les transformations appliquées, selon les exigences du contexte. Elles doivent survivre autant que possible aux opérations de partage et rester documentées pour les intégrateurs downstream.
Cette interopérabilité améliore aussi l’expérience utilisateur. Un destinataire qui consulte un document dans un autre outil peut comprendre son origine sans devoir revenir à l’application initiale. Pour les déploiements transfrontières ou les administrations publiques, l’usage de formats et de composants standardisés facilite la cohérence des interfaces et la preuve de conformité.
Organiser la gouvernance et les preuves de conformité
La conformité des modèles locaux doit couvrir toute la chaîne : choix du modèle, préparation des données, intégration, interface, surveillance et retrait. Les fournisseurs de modèles de base doivent fournir aux intégrateurs des informations sur les capacités et les limites du modèle. Les messages d’aide et avertissements affichés dans l’UI doivent refléter cette documentation technique réelle, sans promettre une fiabilité inexistante.
Les équipes produit doivent conserver un dossier de conception comprenant la cartographie des données, les finalités, les bases légales, les mesures de sécurité, les résultats de tests et les décisions de gouvernance. Pour les systèmes à haut risque, les obligations peuvent inclure un registre, une évaluation d’impact sur la protection des données et des procédures spécifiques pour les autorités publiques. Le niveau d’exigence dépend du rôle de l’organisation et du contexte d’utilisation.
Depuis le 2 août 2026, le calendrier d’enforcement de l’AI Act donne une portée opérationnelle à ces exigences. L’AI Pact peut aider les équipes à se préparer volontairement, tandis que les travaux de standardisation et des initiatives comme l’EU LDT Toolbox illustrent la direction européenne vers des solutions interopérables, documentées et maîtrisables. La conformité devient ainsi un sujet d’architecture produit, et non une vérification finale.
Adapter une interface aux modèles locaux revient à concevoir un système complet : rapide, explicite, sécurisé et capable de limiter les données qu’il manipule. La performance ne se mesure donc pas uniquement au temps de réponse. Elle inclut la capacité à expliquer le rôle de l’IA, à prévenir les usages dangereux, à préserver les informations personnelles et à produire des traces vérifiables.
Pour les entreprises européennes, la meilleure stratégie consiste à intégrer ces exigences dans le design system, les composants d’interface et les pipelines de développement. Une gouvernance cohérente, des tests réguliers et une documentation de bout en bout permettent de tirer parti des modèles locaux sans confondre hébergement maîtrisé et conformité automatique.